robótica educativa · IA embebida · Raspberry Pi · Hugging Face
Robótica modular: cómo funcionan los kits educativos con IA
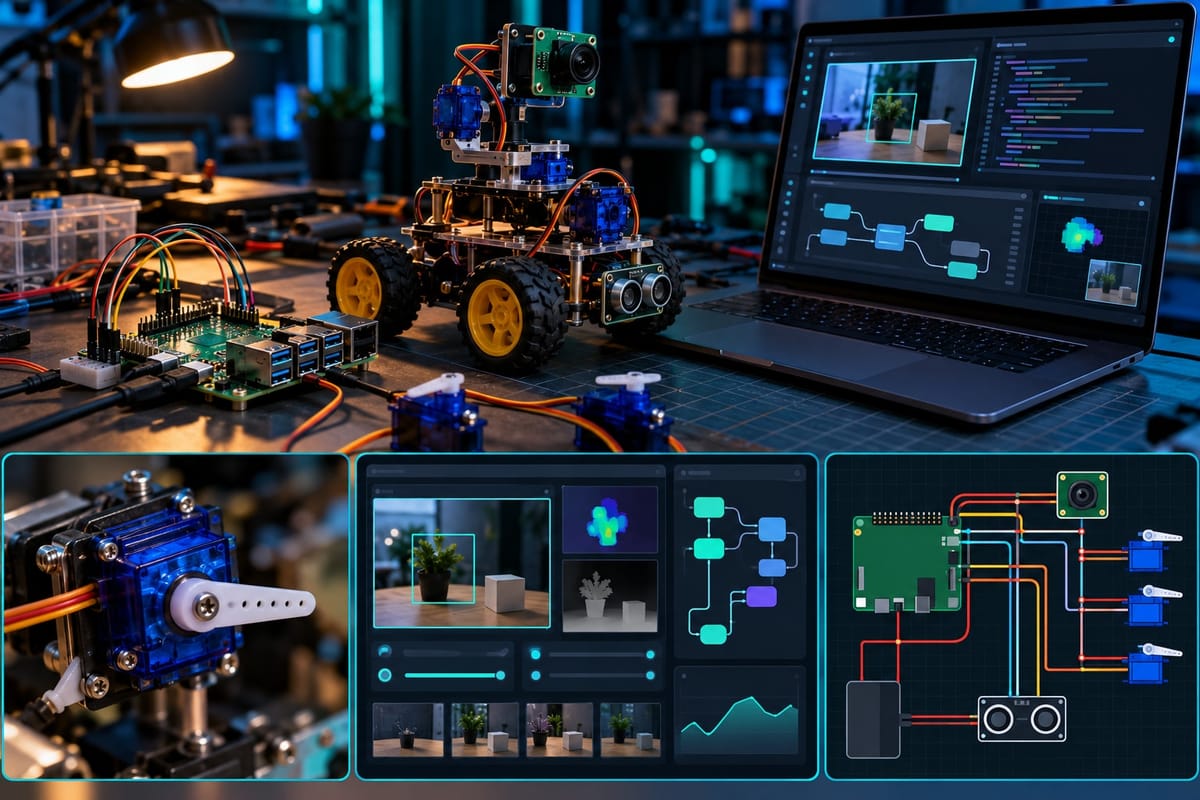
Los kits de robótica modular han democratizado la inteligencia artificial embebida. Hoy es posible integrar modelos de aprendizaje automático en robots educativos usando hardware accesible: placas de desarrollo como Raspberry Pi o microcontroladores ESP32, sensores estándar y librerías open-source. Este artículo analiza la arquitectura técnica de estos sistemas, las plataformas más utilizadas y cómo desplegar modelos ligeros desde repositorios como Hugging Face.
Arquitectura de un robot educativo modular con IA
Un robot educativo con IA consta de tres capas: hardware de control (placa principal con CPU/GPU), periféricos sensoriales (cámaras, micrófonos, IMU, ultrasonidos) y actuadores (servomotores, motores DC, LEDs). La placa principal ejecuta el bucle de control y el modelo de inferencia; los sensores capturan datos en tiempo real; los actuadores traducen las decisiones del modelo en movimiento o respuesta física.
La modularidad reside en buses de comunicación estandarizados: I²C para sensores de baja velocidad (acelerómetros, barómetros), SPI para pantallas y tarjetas SD, UART para módulos GPS o Bluetooth, y PWM para control de servos. Esta separación permite reemplazar componentes sin modificar el firmware base, lo que resulta ideal para entornos educativos donde los estudiantes experimentan con distintas configuraciones.
Placas de desarrollo: Raspberry Pi vs microcontroladores
Raspberry Pi 4 o 5 ofrece CPU quad-core ARM Cortex-A76, hasta 8 GB de RAM y sistema operativo completo (Raspberry Pi OS, Ubuntu). Es la opción preferida cuando se necesita ejecutar frameworks de Python como TensorFlow Lite, PyTorch Mobile o pipelines de Hugging Face Transformers. Su ventaja: capacidad para cargar modelos preentrenados de visión (MobileNet, EfficientNet) o procesamiento de lenguaje natural sin necesidad de cuantización extrema. Su desventaja: consumo energético mayor (5–15 W) y tiempo de arranque lento frente a microcontroladores.
Microcontroladores ESP32 o Arduino Portenta H7 tienen RAM limitada (520 KB en ESP32, 8 MB en Portenta) y no ejecutan sistema operativo, pero arrancan en milisegundos y consumen menos de 1 W. Son ideales para modelos cuantizados a 8 bits mediante TensorFlow Lite Micro o Edge Impulse. Aquí la inferencia se reduce a redes neuronales compactas: clasificadores de audio de pocos kilobytes, detección de gestos con acelerómetro o reconocimiento de palabras clave. La limitación está en la complejidad del modelo, no en la viabilidad del despliegue.
| Plataforma | RAM | Inferencia típica | Consumo | Caso de uso |
|---|---|---|---|---|
| Raspberry Pi 4/5 | 2–8 GB | TensorFlow Lite, PyTorch | 5–15 W | Visión por computador, NLP ligero |
| Jetson Nano | 4 GB | TensorRT, CUDA | 5–10 W | Inferencia acelerada por GPU |
| ESP32 | 520 KB | TFLite Micro | <1 W | Clasificación de audio, gestos |
| Arduino Portenta H7 | 8 MB | TFLite Micro, Edge Impulse | <2 W | Sensores industriales, wearables |
Integración de modelos desde Hugging Face
Hugging Face aloja más de 500.000 modelos preentrenados, muchos optimizados para dispositivos embebidos. Para robótica educativa, los más relevantes son modelos de visión (image-classification, object-detection), audio (automatic-speech-recognition, audio-classification) y texto (text-classification, token-classification). El flujo de trabajo típico incluye selección del modelo, exportación a formato ONNX o TensorFlow Lite, cuantización y despliegue en la placa.
- Seleccionar modelo ligero: buscar en Hugging Face Hub filtrando por tamaño (<50 MB) y tarea. Ejemplos: google/mobilenet_v2_1.0_224 para clasificación de imágenes, facebook/wav2vec2-base cuantizado para reconocimiento de voz.
- Exportar a formato embebido: usar optimum.onnxruntime o tf.lite.TFLiteConverter para convertir el modelo PyTorch/TensorFlow a ONNX o TFLite. Aplicar cuantización dinámica (float16) o estática (int8) según la RAM disponible.
- Desplegar en la placa: copiar el archivo .tflite o .onnx a la Raspberry Pi, cargar con tflite_runtime o onnxruntime, y ejecutar inferencia en bucle con frames de cámara o muestras de audio.
- Validar latencia: medir tiempo de inferencia con time.perf_counter(). Objetivo: <100 ms por frame en Raspberry Pi 4, <50 ms en microcontroladores con modelos ultra-ligeros.
Configuración de sensores y pipelines de datos
Los sensores determinan qué tipo de IA puede ejecutarse. Cámaras (Raspberry Pi Camera Module V2, OV2640 en ESP32) capturan imágenes RGB de 640×480 o superiores, necesarias para clasificación de objetos o seguimiento visual. El preprocesamiento incluye redimensionado a la entrada del modelo (224×224 para MobileNet), normalización de píxeles (0–1 o -1 a 1) y conversión de color si el modelo espera RGB en lugar de BGR.
Micrófonos I²S (INMP441, SPH0645) permiten captura de audio a 16 kHz, suficiente para reconocimiento de comandos de voz. El audio se segmenta en ventanas de 1 segundo, se convierte a espectrograma mel (usando librosa o scipy) y se alimenta a modelos como Wav2Vec2 o Yamnet. Sensores inerciales (MPU6050, LSM6DS3) proporcionan aceleración y giroscopio a 100–200 Hz, útiles para clasificación de gestos o detección de caídas mediante redes convolucionales 1D.
El pipeline completo en Python para clasificación de imágenes en Raspberry Pi luce así: captura de frame con picamera2, redimensionado con cv2.resize(), normalización, inferencia con tflite_runtime.Interpreter.invoke(), extracción de logits y activación de actuador según la clase predicha. Este bucle se ejecuta a 5–10 FPS en Raspberry Pi 4 con MobileNetV2, suficiente para robots móviles en entornos controlados.
Frameworks y librerías para IA embebida
- TensorFlow Lite: runtime oficial de Google para inferencia en ARM y microcontroladores. Soporta cuantización completa y delegados de GPU (OpenGL, Vulkan) en Raspberry Pi.
- ONNX Runtime: motor de inferencia multiplataforma compatible con modelos de PyTorch, TensorFlow y scikit-learn. Más flexible que TFLite para prototipos rápidos.
- Edge Impulse: plataforma de extremo a extremo para entrenar, optimizar y desplegar modelos en Arduino, ESP32 y otros MCU. Genera firmware listo para flashear.
- OpenCV: librería de visión por computador con módulos de DNN (cv2.dnn) que cargan modelos ONNX y Caffe. Útil para preprocesamiento y posprocesamiento visual.
- PyTorch Mobile: versión ligera de PyTorch para Android e iOS, también funcional en ARM Linux. Requiere más RAM que TFLite pero mantiene el grafo dinámico.
La elección depende del ecosistema: TensorFlow Lite si vienes de Keras/TensorFlow, ONNX Runtime si usas PyTorch, Edge Impulse si priorizas velocidad de prototipado en hardware muy limitado. Para [page:a4-es-es](simulación previa), muchos desarrolladores entrenan en Gazebo o PyBullet y exportan directamente a TFLite.
Ejemplo práctico: robot clasificador de objetos con Raspberry Pi
Un proyecto educativo típico: robot móvil con cámara que identifica objetos domésticos y emite un pitido según la clase. Hardware: Raspberry Pi 4 (4 GB), Pi Camera V2, chasis con motores DC controlados por puente H L298N, altavoz USB. Software: Raspberry Pi OS Lite, Python 3.11, OpenCV, TensorFlow Lite, modelo MobileNetV2 cuantizado int8 descargado de Hugging Face.
El script de inferencia captura frames a 10 FPS, los redimensiona a 224×224, normaliza a [-1, 1], ejecuta interpreter.invoke(), obtiene el top-1 class y mapea a etiquetas ImageNet. Si detecta «botella», activa GPIO para emitir un tono; si detecta «teclado», otro tono distinto. La latencia total es ~80 ms por frame, permitiendo navegación reactiva en tiempo real.
Este diseño es escalable: se pueden reemplazar motores DC por servos para [page:a2-es-es](locomoción cuadrúpeda), añadir un micrófono para comandos de voz o integrar sensores de ultrasonido para evitar obstáculos. La modularidad del hardware y la abundancia de modelos preentrenados reducen la barrera de entrada para estudiantes de secundaria y universidad.
Desafíos y limitaciones de la IA embebida en robótica educativa
Latencia vs precisión: modelos más pequeños infieren más rápido pero cometen más errores. Un MobileNetV2 cuantizado tiene ~70 % top-1 accuracy en ImageNet, frente a ~76 % de la versión float32. En aplicaciones educativas esto es aceptable, pero en robótica industrial requiere validación exhaustiva.
Limitaciones de RAM: microcontroladores con <1 MB de RAM solo ejecutan redes de pocas capas. Modelos transformer (BERT, GPT) quedan fuera de alcance; las alternativas son redes convolucionales o recurrentes compactas entrenadas desde cero o destiladas.
Dependencia de conectividad: si el modelo no cabe en la placa, la alternativa es inferencia en la nube (API REST a servidor con GPU). Esto añade latencia de red (100–500 ms) y exige conexión permanente, limitando la autonomía del robot. Proyectos educativos deben equilibrar portabilidad del modelo con requisitos de conectividad.
Coste y disponibilidad: Raspberry Pi 4 cuesta ~60 €, ESP32 ~10 €, pero sensores de calidad (cámaras CSI, IMUs de 9 ejes) pueden sumar 30–50 € más. Kits completos educativos rondan 100–150 €, accesibles para instituciones pero no siempre para estudiantes individuales.
Recursos y comunidades para profundizar
La comunidad de robótica educativa con IA es activa en GitHub, foros de Raspberry Pi y Discord de Hugging Face. Repositorios como tensorflow/examples y huggingface/optimum ofrecen tutoriales paso a paso para desplegar modelos en ARM. [page:a3-es-es](Centros de investigación en España) también publican guías y datasets localizados para proyectos en castellano.
Plataformas como Edge Impulse y Teachable Machine de Google permiten entrenar modelos personalizados sin escribir código, ideales para introducir IA a estudiantes de secundaria. Para niveles avanzados, la lectura de whitepapers sobre cuantización (Jacob et al., 2018) y arquitecturas móviles (Howard et al., 2017) es recomendable.
La robótica modular con IA embebida convierte conceptos abstractos de aprendizaje automático en experiencias tangibles. Combinar hardware accesible, modelos preentrenados de Hugging Face y librerías open-source permite construir robots funcionales en semanas, no meses. La clave está en elegir la plataforma según los recursos disponibles, dimensionar correctamente el modelo y validar el rendimiento en condiciones reales antes de escalar el proyecto.